登录
- 微信登录
- 手机号登录
微信扫码关注"汇帮科技"快速登录
Loading...
其他登录方式
了解汇帮音频分离软件最新动态
做短视频配音、翻唱扒带或者后期修音时,经常需要从一首完整的歌曲中提取人声分离软件哪个好,这本质上是音频源分离(Music Source Separation)技术的应用。传统的相位抵消法对音质损伤大且操作繁琐,而基于深度学习的U-Net架构模型可以将人声与伴奏在频谱图上精准切分。
在对比了在线工具、开源脚本和商业软件后,本文记录一套高可复现的本地解决方案——汇帮语音分离软件,并补充命令行工具Spleeter的对比实践,帮你根据自己的技术栈做选型。
汇帮语音分离软件提供了完整的图形化交互逻辑,其内置的AI模型对流行音乐的分离度表现稳定。以下操作流程在Windows 11环境下验证。
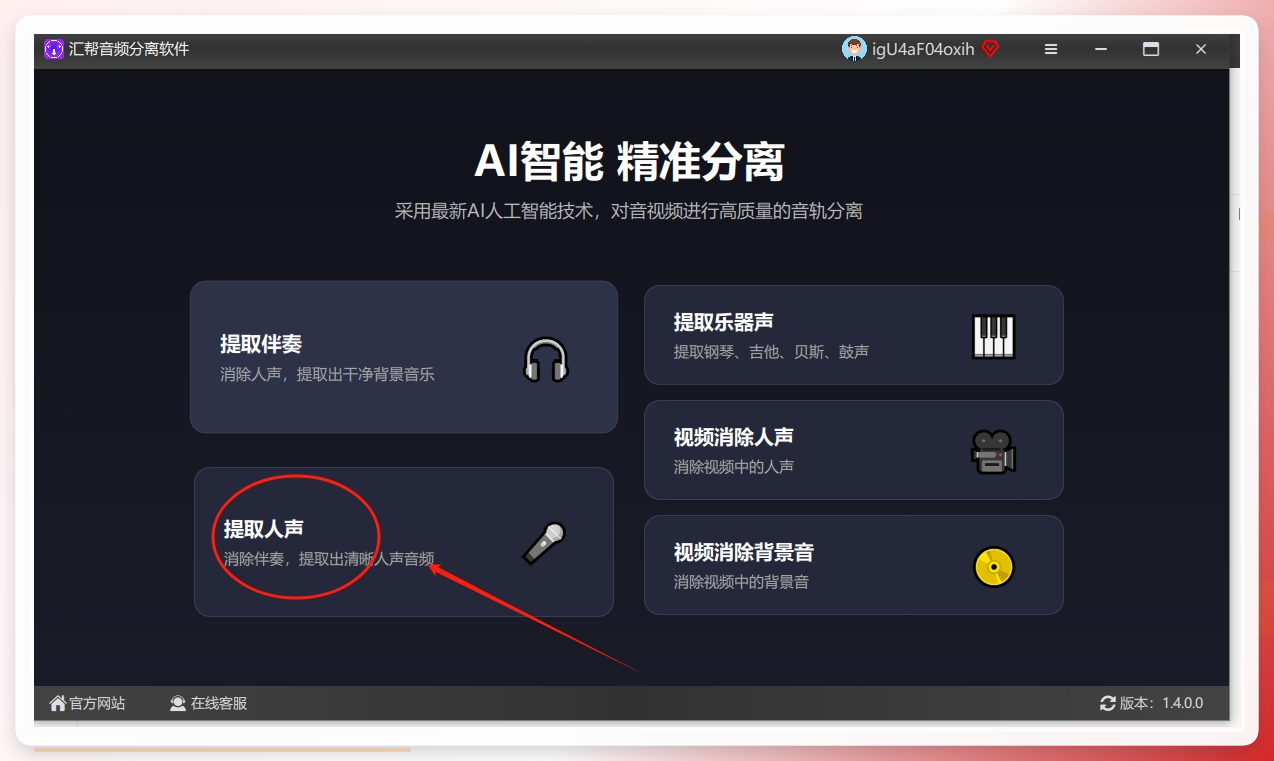
安装后打开【汇帮语音分离软件】,主界面功能按钮清晰,这里直接点击“提取人声”进入专项工作流。
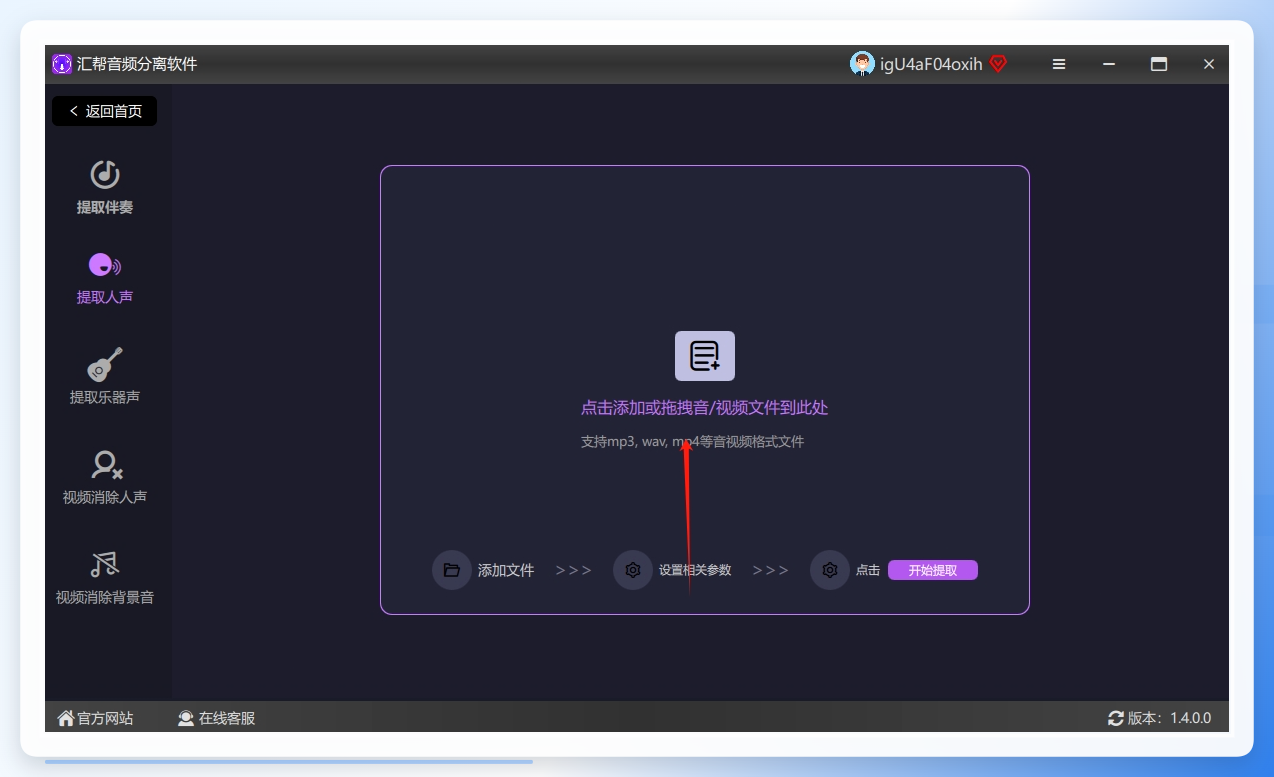
进入操作界面后,点击中间“点击这里导入音频”的区域,在弹出的资源管理器中选中目标文件。软件支持MP3、WAV、FLAC等常见无损/有损格式,如果原曲是高清FLAC,建议优先导入该格式以保留更多细节。
这里有个容易踩的坑:如果后期需要进DAW(数字音频工作站)精修,建议在左下角将输出格式从默认的MP3改为WAV,比特率保持原始采样率即可。若仅用于试听或临时采样,MP3 320kbps足够。
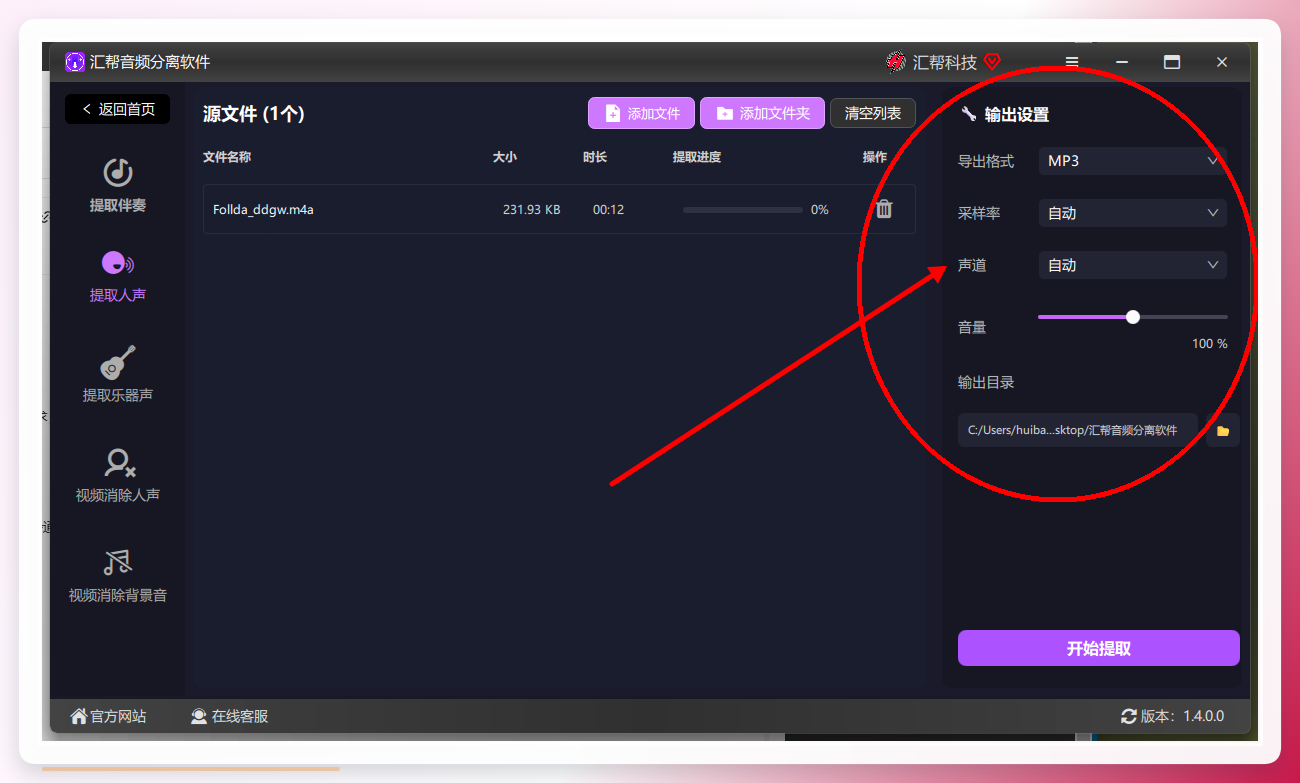
点击右上角“开始提取”按钮,软件通过AI算法计算分离。此时不建议进行其他高CPU占用操作,等待进度条走完,通常一首4分钟左右的歌曲在30-60秒内完成。
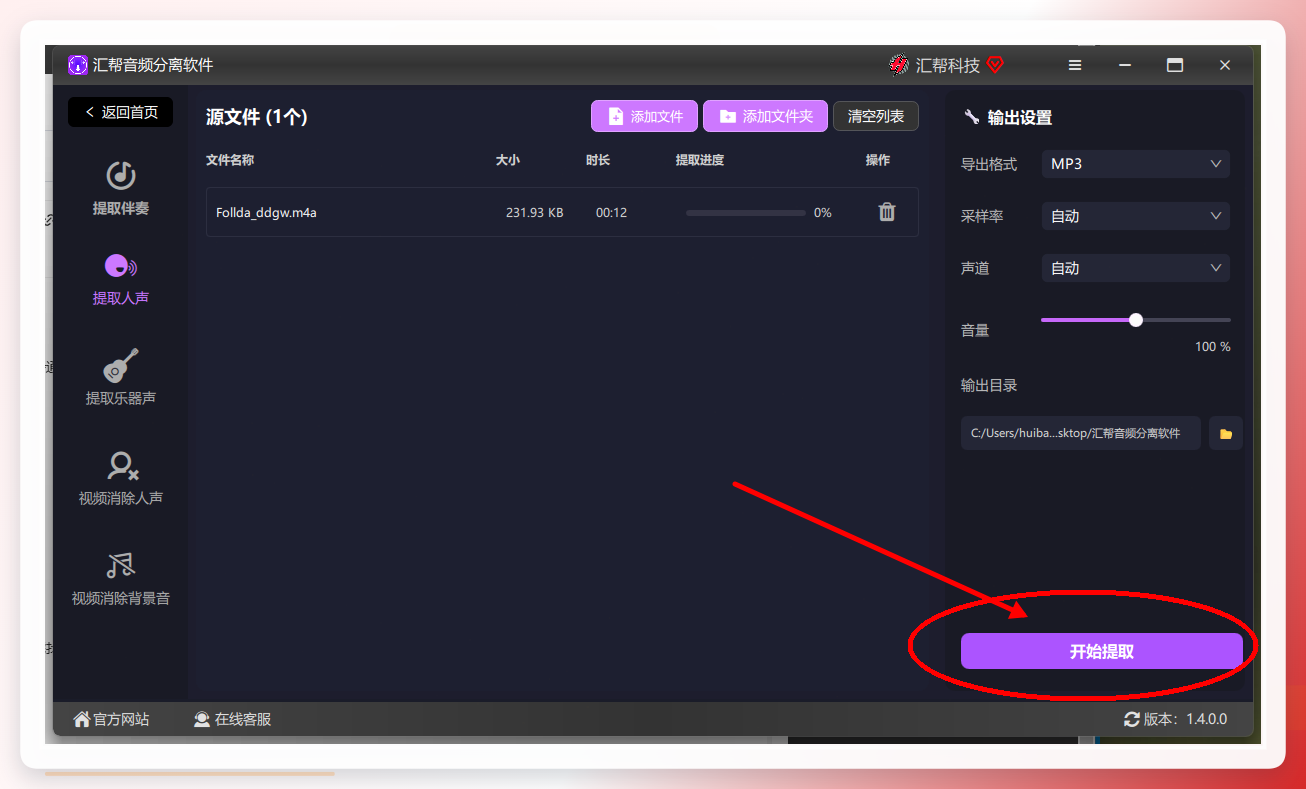
处理完成后弹出提示框,点击“前往导出文件夹查看”即可找到单独的干声文件。
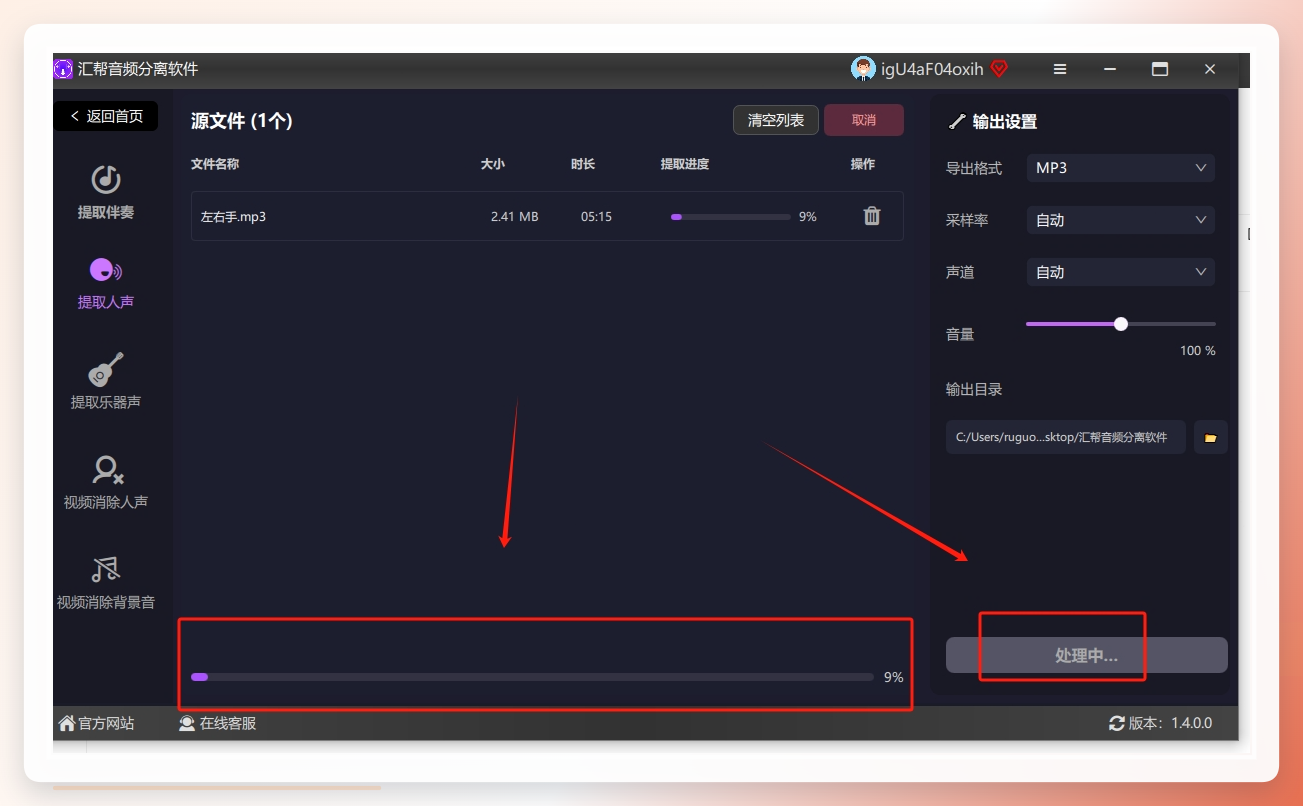 限制与风险:虽然该工具对完整混音分离效果良好,但对已带有强烈混响或特殊电音处理的片段,分离出的人声可能会残留部分底色噪音,属于物理极限,非软件故障。
如果你熟悉Python或需要将分离功能集成到自动化流水线中,Deezer开源的Spleeter是首选。它提供了预训练的2stems(人声/伴奏)和4stems/5stems模型。
conda create -n spleeter python=3.7
conda activate spleeter
pip install spleeter
在终端直接调用命令行:
spleeter separate -i ./input/song.mp3 -o ./output -p spleeter:2stems
关键参数解释:
-i:输入音轨路径。-o:输出目录,结果会生成 song/vocals.wav 与 song/accompaniment.wav。-p:模型预设,2stems 只分离人声和伴奏。若看到 vocals.wav 生成,即为干净的人声轨道。实际测试中,Spleeter的分离速度极快(GPU环境下可实时),但码率转换时偶尔会丢失微弱的高频泛音。
限制与风险:纯命令行操作对非技术用户门槛高,且如果显卡不支持CUDA,仅靠CPU处理长音频速度会明显变慢。
除了上述两种方案,以下工具也值得关注:
:在线网页工具,上传完自动处理。
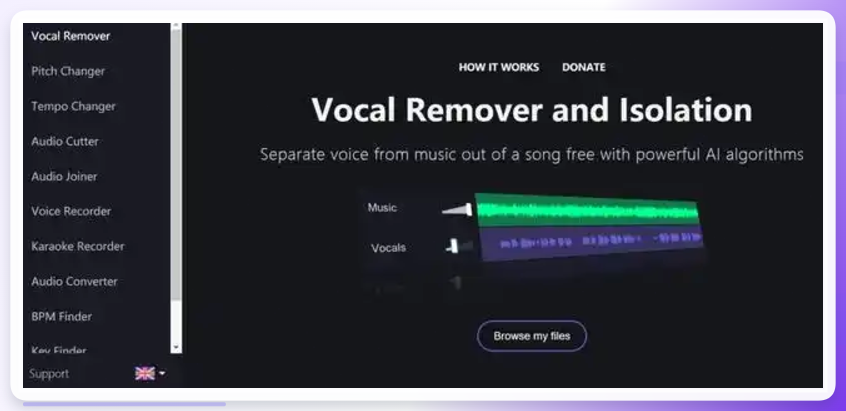 适合临时应急使用,但上传大文件受网络带宽限制。
:手机端应用,支持两轨/多轨分离。
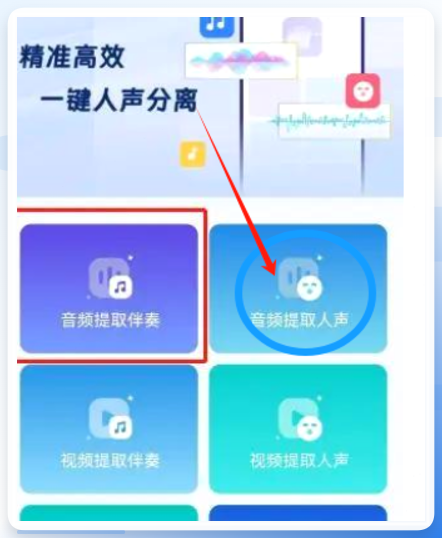 适合移动端快速出片,云端处理不耗本地资源。
:免费在线分离工具,支持视频文件直接导入。
 不仅分离人声,还能拆解鼓组、贝斯、钢琴等分轨。
对比维度
汇帮语音分离软件
Spleeter(命令行)
操作门槛
图形化,零代码
需要Python基础
处理效率
中等,稳定
极高(GPU加速)
批处理
内置队列支持
需自行编写循环脚本
资源占用
较低
较高(依赖TensorFlow)
关于提取人声分离软件哪个好,我的结论是:如果是单次或小批量处理、追求上手即用,汇帮语音分离软件是最省事的方案;如果你需要把分离能力嵌入自动化处理管线,Spleeter的脚本化调用更具优势。 在线工具可以作为补充手段,但涉及隐私录音文件时,不建议上传至第三方服务器。
如果你在操作中遇到分离后噪声较大或模型加载失败的问题,欢迎在评论区留言,我会尽量给出排查思路。
 汇帮音频分离软件
