
技术背景与需求分析
在日常开发和办公场景中,我们经常需要处理会议录音、访谈记录、客户语音留言等非结构化音频数据。将这些音频内容快速、准确地转换为可编辑的文本格式,是知识沉淀和流程自动化的关键一步。市面上虽然有不少 语音转文字软件,但往往面临识别准确率低、操作繁琐、数据安全无法保障等问题。
本文将从一个实际需求出发——将一段MP3格式的采访录音转换为Word文档,来对比三种主流的实现路径。这不仅是工具推荐,更是一次完整的技术选型记录,希望能为遇到类似需求的开发者或办公人员提供一个可复现的参考。
方案一:使用汇帮AI语音识别软件
对于无代码基础的用户,汇帮AI语音识别软件提供了图形化的替代方案,具体配置流程如下:
1. 核心功能优势
- 本地转换机制:音频文件在本地设备完成识别,无需上传至云端服务器,适合处理涉及隐私的商务会谈或客户资料。
- 高精度识别引擎:采用针对中文语境优化的AI模型,实测对普通话、略带口音的英语以及中英混说的场景,均能达到较高的字准率。
- 一键导出Word:无需从TXT文本再手动调整格式,软件能根据语音停顿段落,直接生成带段落结构的Word文档,大幅减少校对时间。
2. 详细操作流程
这里以“将interview.mp3转换为访谈纪要.docx”为例,分解整个操作步骤。
步骤1:启动软件与选择功能
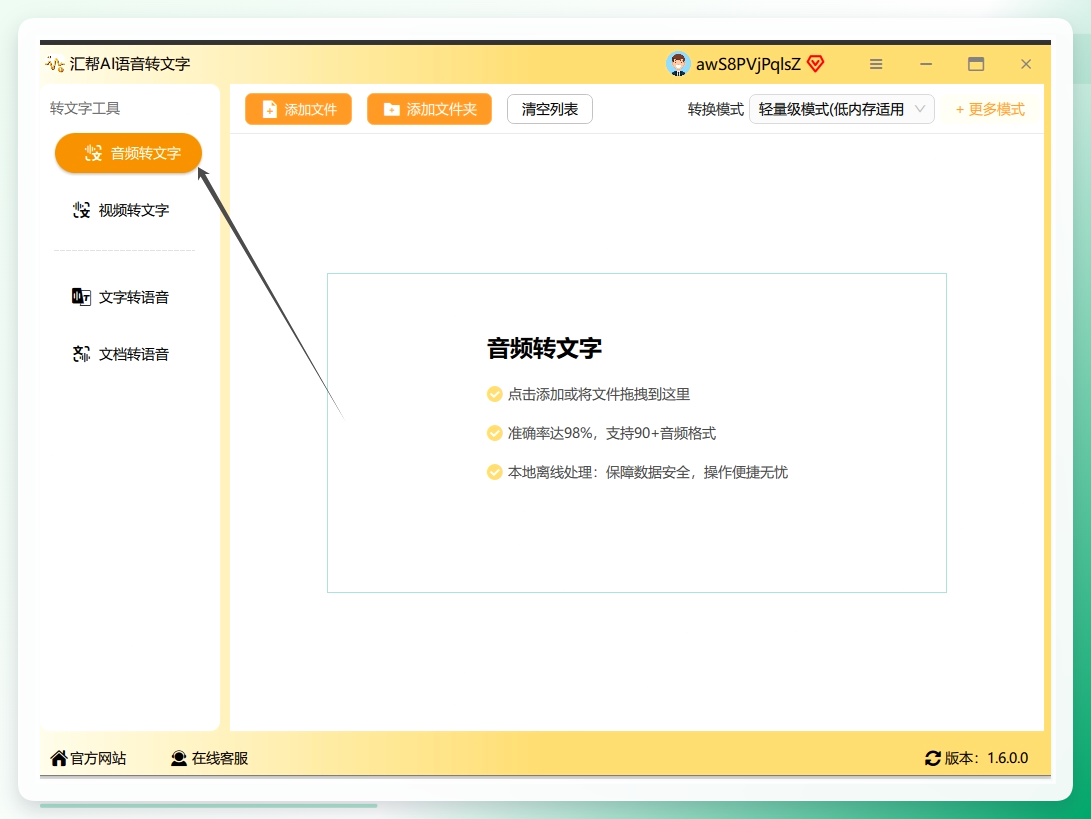
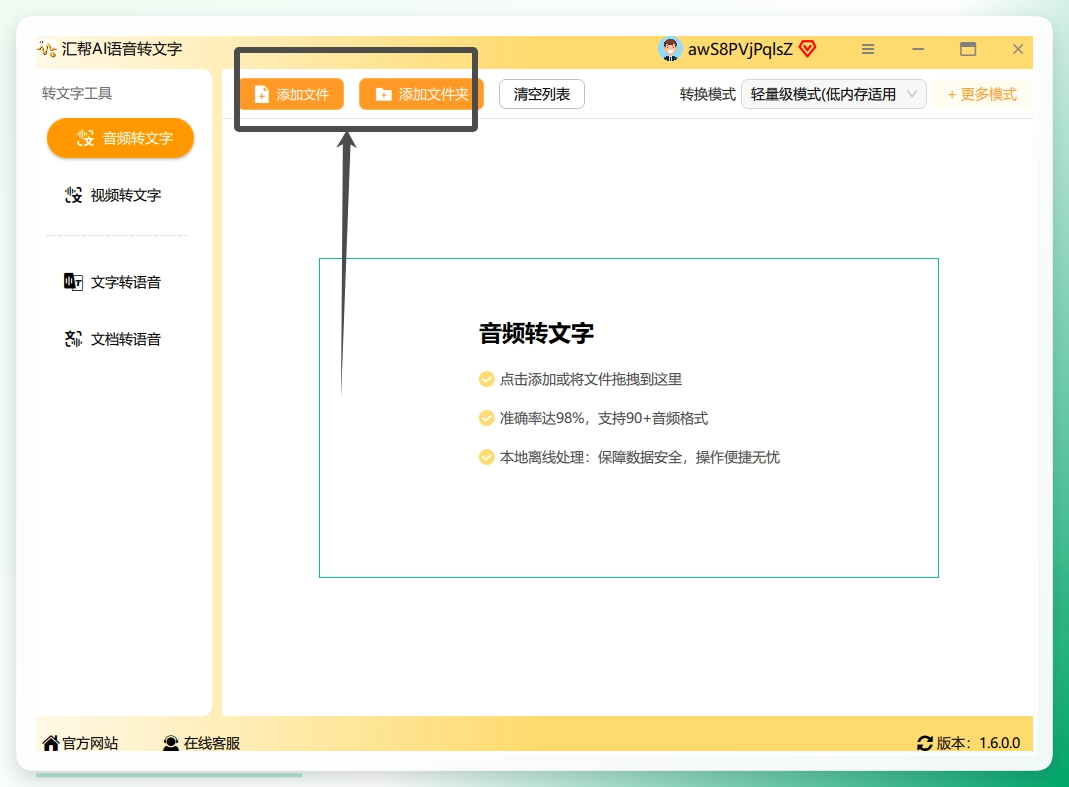
在你的电脑上双击打开汇帮AI语音识别软件,进入主界面后,点击左侧菜单栏中的【音频转文字】功能模块。
步骤2:添加待识别音频文件
点击界面左上角的“添加文件”按钮(部分版本显示为“选择文件”),在弹出的对话框中选择需要转换的MP3或WAV格式录音文件。软件支持批量导入,如果有多段录音需要合并转换,可以一次性全选添加。
步骤3:配置输出格式与语种
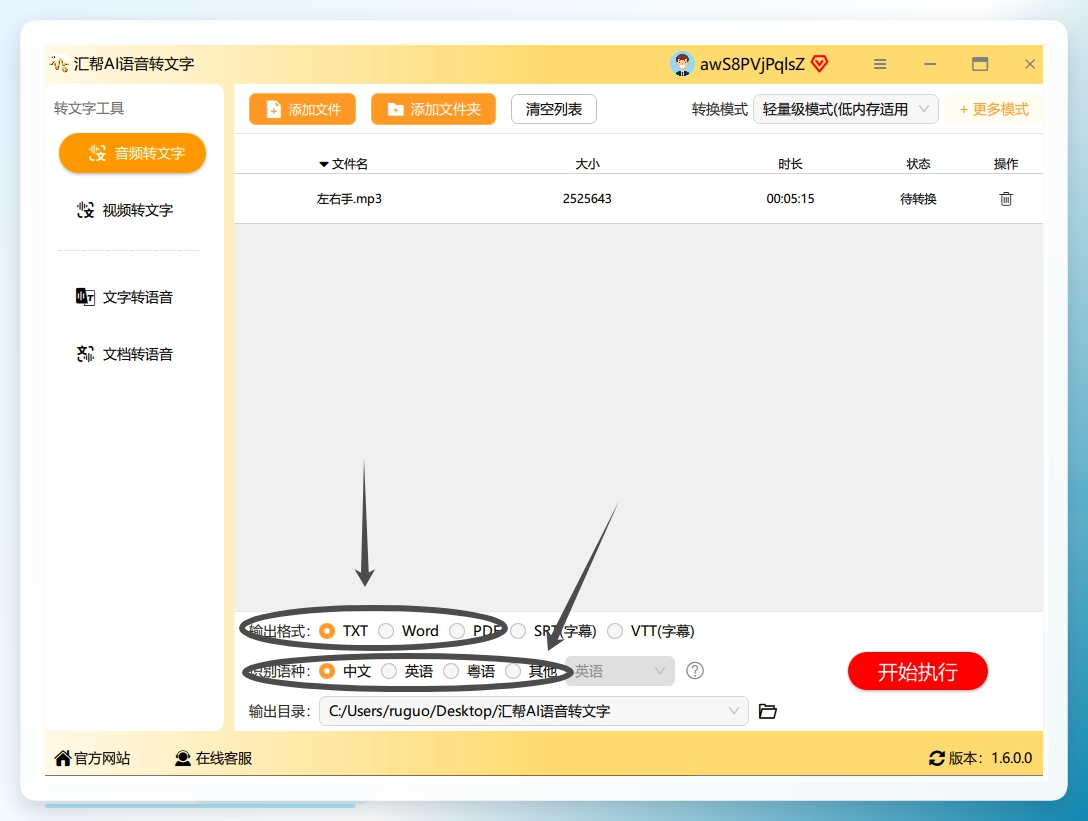
这是最关键的一步。在输出格式区域,点击下拉菜单并选择“Word文档(*.docx)”。同时,根据录音的实际内容,在语种识别选项中选择对应的语言(如“中文”、“英语”或“日语”),以确保识别引擎调用正确的语言模型。
步骤4:执行转换并导出
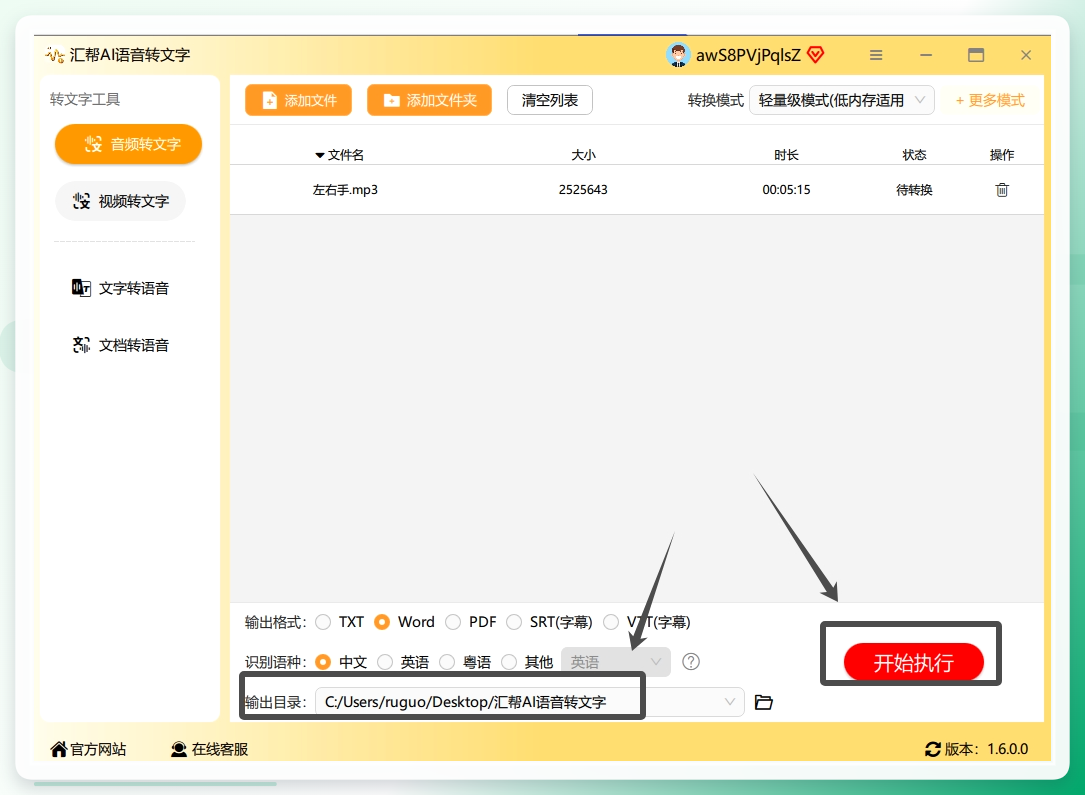
确认参数无误后,点击页面右下角的“开始转换”按钮。
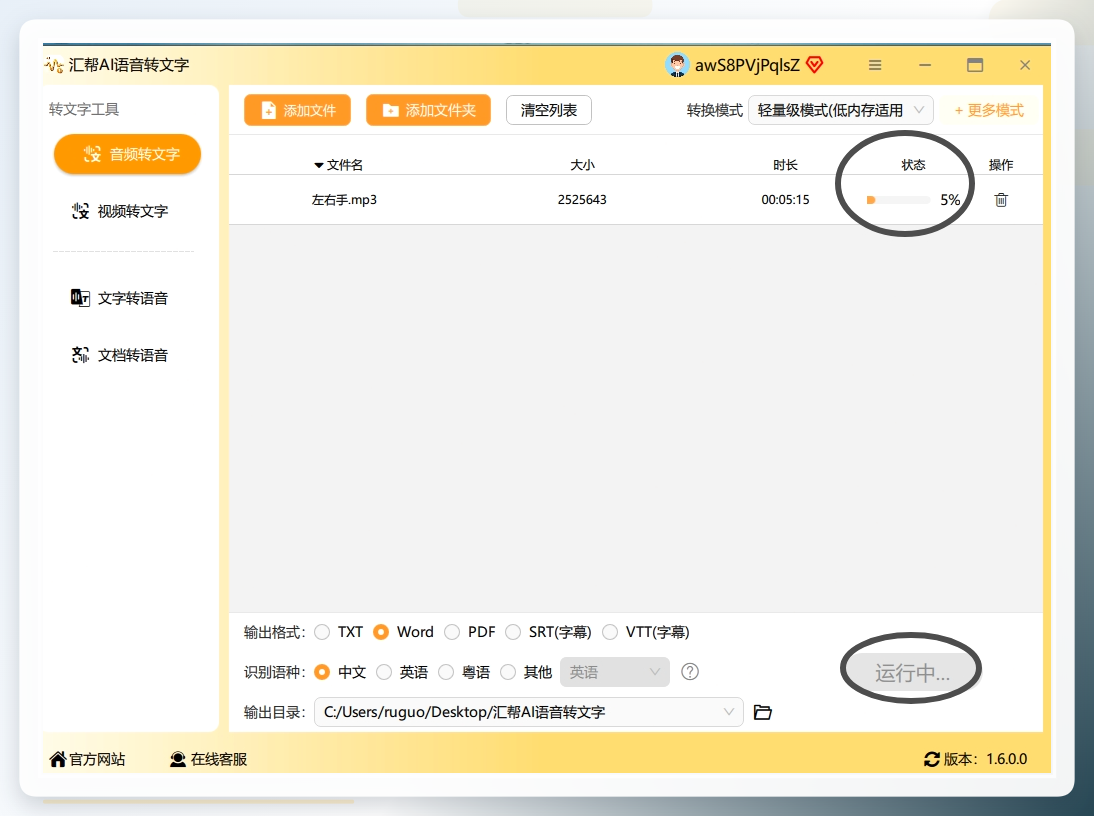
 转换速度取决于音频时长,通常一段10分钟的录音在1分钟内即可完成。当界面提示“转换成功”时,点击“打开文件目录”,即可找到已经排版好的Word文档。
 限制与提示:该软件为标准Windows桌面应用,暂时没有提供原生的Linux或macOS版本。在Mac环境下可尝试通过虚拟机运行,但会影响转换性能。
方案二:使用剪映的“识别字幕”功能
作为视频剪辑工具,剪映内置的识别字幕功能在应对视频文件中的对白转写时非常高效。
1. 适用场景与边界
该功能适合视频博主将短视频中的口播内容快速转为字幕。它的操作逻辑是引导用户利用云端算力进行转写。
2. 操作实录
- 打开剪映,导入需要处理的视频文件。
- 将视频拖拽至时间轴,点击顶部菜单栏的“文本” -> “智能字幕”。
- 点击“开始识别”按钮,等待云端处理完成。
- 处理完毕后,字幕会以时间轴文本形式呈现,可直接导出为TXT或SRT格式。
风险提示:由于视频文件需上传至字节跳动服务器进行解析,涉及商业机密或未公开代码的屏幕录制视频,不建议使用此方案。
方案三:使用Whisper开源命令行工具
对于熟悉Python生态的开发者,OpenAI开源的Whisper模型提供了高度可定制化的批量处理能力。
1. 环境配置
确保本机已安装Python 3.9+及FFmpeg依赖库,执行以下命令安装Whisper基础环境:
pip install openai-whisper
2. 高效转写
使用一行命令即可实现与前述方案等效的功能,但Whisper支持将识别结果直接以.srt、.vtt或纯文本形式输出。以下命令将生成包含时间戳的Word可读文本:
whisper interview.mp3 --language Chinese --task transcribe --output_format txt --output_dir ./output
优势与门槛:该方案的优势在于完全免费且支持99种语言的转写;但门槛在于需要显卡算力支撑。若使用CPU跑一个小时的音频,耗时可能长达数小时,且命令行操作对非技术用户并不友好。
方案总结与选型建议
技术选型不应只看功能列表,更要看使用场景和数据边界。
- 如果是办公室文员处理涉密的客户录音,优先选择方案一(汇帮AI语音识别),本地转换更安心,且支持的输出格式(Word/SRT/TXT)已覆盖绝大多数会议纪要场景。
- 如果是视频创作者处理剪辑素材中的字幕,方案二(剪映)的云端智能字幕是效率最高的选择。
- 如果是开发者需要免费批量处理大量历史音频数据,且不介意折腾环境,方案三(Whisper)值得深入研究。
除了以上提到的问题,你是否在音频转写时遇到过长音频无法处理或识别乱码的情况?欢迎在评论区分享你的问题或经验,我们一起排查。
#语音转文字 #音频转文字 #效率工具 #AI识别 #技术选型
