
文字转语音(Text-to-Speech,TTS)是将书面文本通过语音合成引擎转换为可播放音频文件的技术,常见输出格式包括 WAV、MP3、M4A 等。TTS 在日常办公和开发中主要承担短视频配音、课程旁白、有声内容批量生成、无障碍朗读等任务。
本文记录一次从文本到音频的完整落地过程,分别测试图形化工具和命令行方案,并给出选型建议。
方案一:使用"汇帮AI语音转文字"完成文字转语音
对于无代码基础的用户,"汇帮AI语音转文字"提供了图形化的替代方案,具体配置流程如下:
1. 核心功能优势
- 可视化参数面板:音色选择、语速调节、音量控制、背景音乐添加均在界面内完成;
- 批量文本支持:文本框支持多段文字同时处理,适合一次性合成多段旁白或课程内容;
- 试听机制:合成前可以先试听,减少因参数设置不当导致的反复导出。
2. 详细操作流程
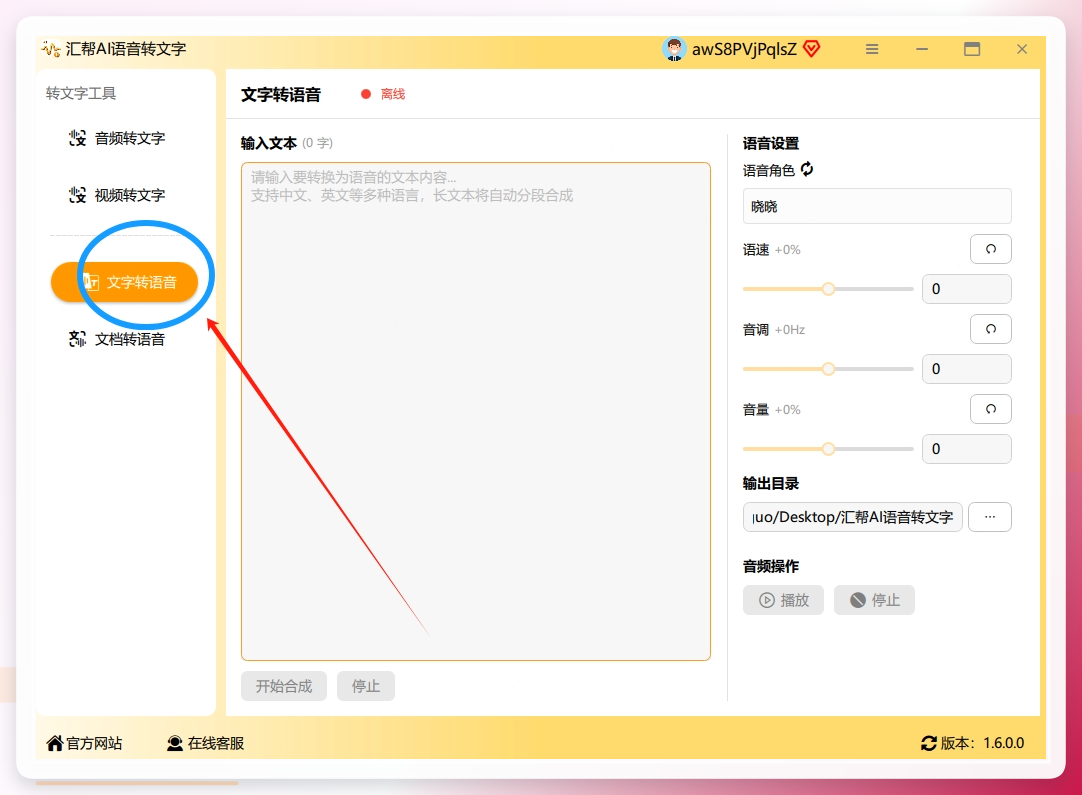
步骤1:进入文字转语音功能
双击打开"汇帮AI语音转文字"软件,在首页找到 【文字转语音】 功能并点击进入。
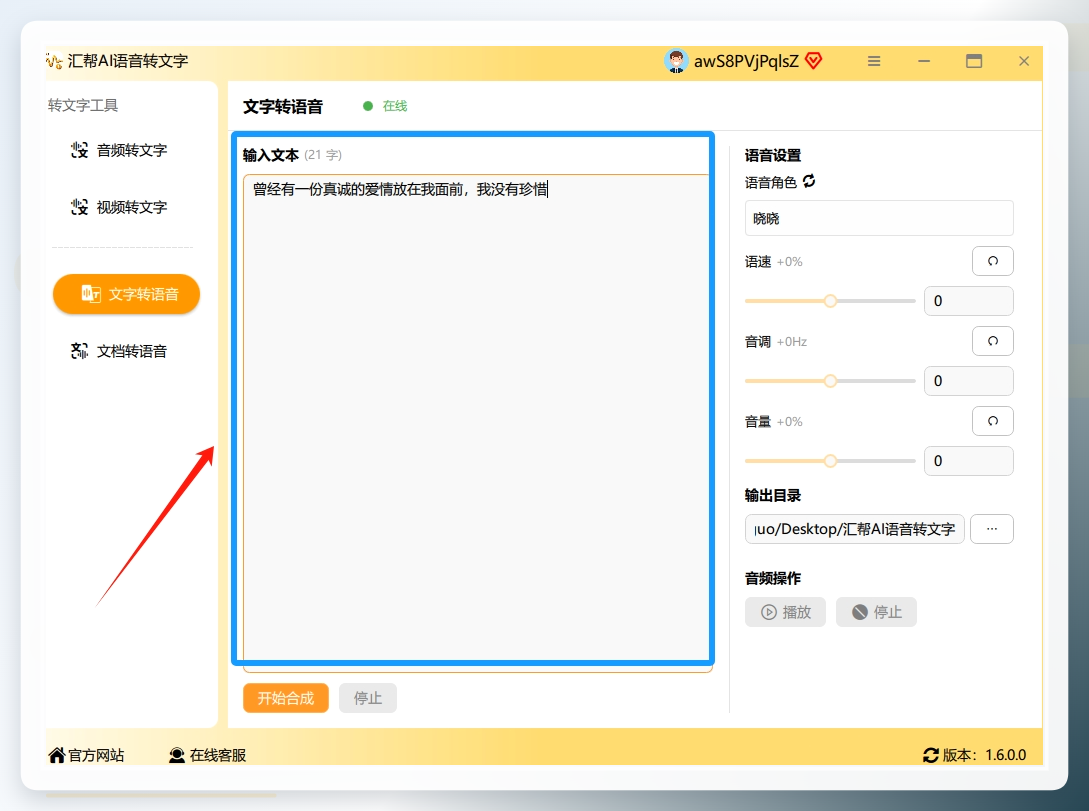
步骤2:输入或粘贴待转换文本
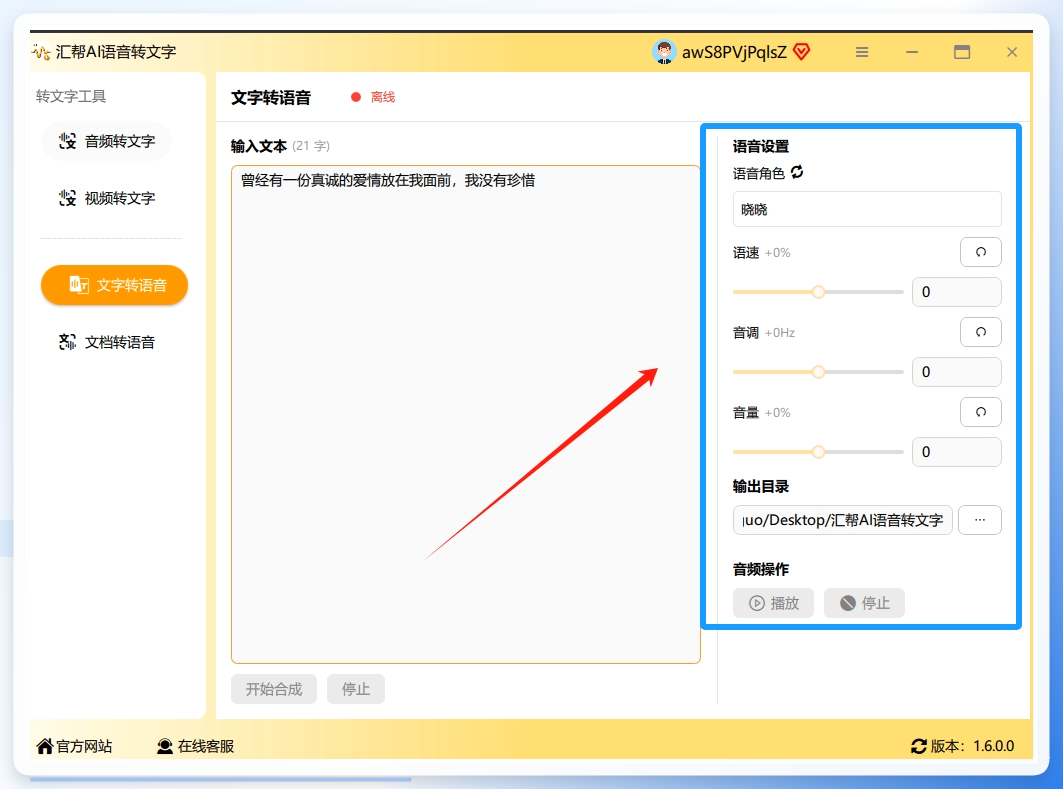
在编辑区域可以看到一个大文本框,既可以复制粘贴准备好的文字,也可以直接手动输入。文本支持多段内容批量处理,段落之间自动识别,不需要额外添加分隔符。
步骤3:设置音色与合成参数
在参数设置区域,可以选择不同的语音类型(比如男声、女声、童声等),还支持添加背景音乐、调整语音速度和音量大小。设置完成后可以先点 “试听” 检查效果,不合适随时调整,这样能有效减少二次转换的概率,提升效率。
步骤4:选择输出目录并开始合成
在输出目录中选择一个合适的文件夹作为音频保存位置,然后点击右下角的 【开始合成】 按钮,稍等片刻就能得到转换成功的音频文件。
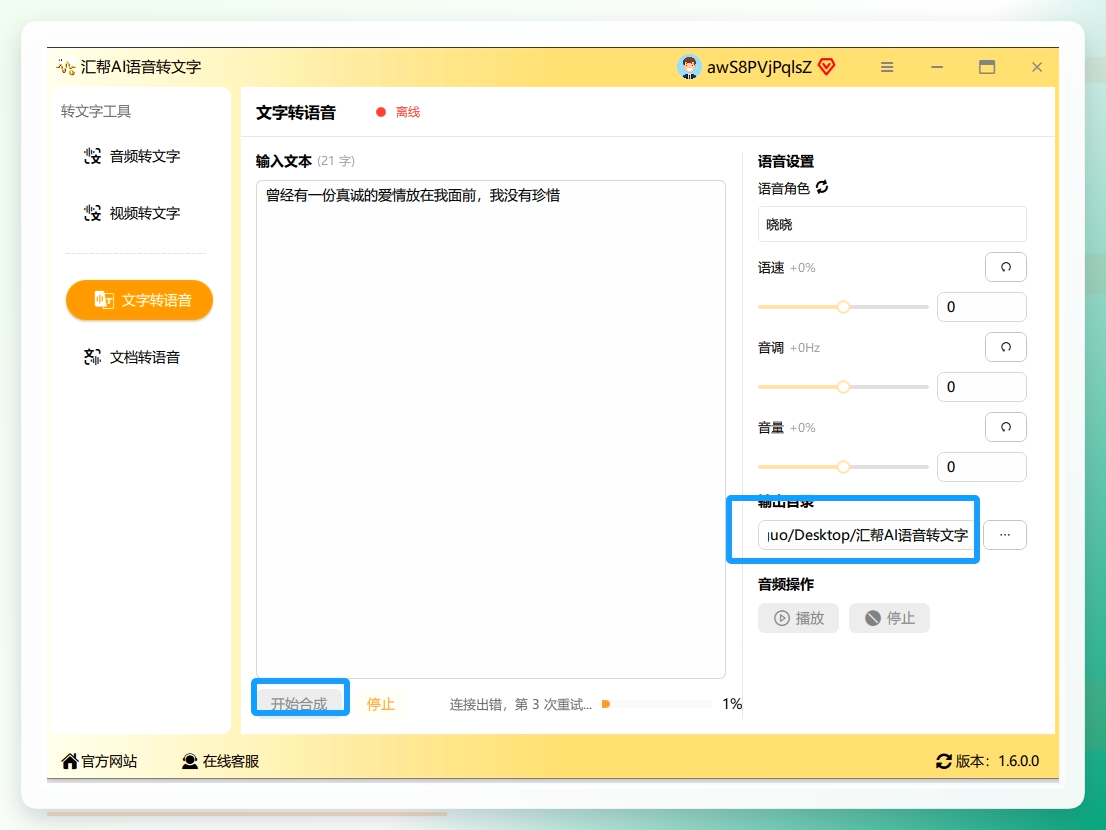 转换完成后,直接在指定文件夹中就能找到生成的音频文件,双击即可播放,也可以直接通过聊天工具发送给需要的人。
3. 使用注意事项
- 文本中包含特殊符号(如
①、②、&)时,部分音色可能朗读异常,建议预处理为普通文字; - 长时间文本(超过 1000 字)建议分段合成,方便单段重录,避免整段返工;
- 输出目录避免选择系统保护目录(如
C:\Program Files),防止权限不足导致写入失败。
方案二:FFmpeg 结合系统 TTS 引擎的命令行方案
对于有命令行操作经验的开发者,可以借助系统自带 TTS 引擎配合 FFmpeg 完成转码和合成,整个过程无需额外安装图形界面软件。
1. 适用场景
- 需要将 TTS 集成到自动构建流程中;
- 需要批量生成大量音频文件;
- 希望减少 GUI 依赖,在服务器或无桌面环境中运行。
2. 操作步骤(以 Windows PowerShell + edge-tts 为例)
确认环境已安装 Python 3.8+ 和 FFmpeg,检查方式:
python --version
ffmpeg -version
安装微软提供的 edge-tts 命令行工具:
pip install edge-tts
生成单条语音并转码为 MP3:
edge-tts --voice zh-CN-XiaoxiaoNeural --text "你好,这是一段测试语音。" --write-media output.mp3
如果需要调节输出码率,可以先用 edge-tts 生成 WAV 原始文件,再交给 FFmpeg 处理:
ffmpeg -i input.wav -b:a 192k -ar 44100 final.mp3
3. 限制与风险
- 依赖网络环境,微软接口在部分网络下可能超时;
- 音色参数仅支持命令行预设值,无法像图形界面那样直接拖拽调节;
- 批量生成时需要自己写循环脚本处理文件命名与异常重试。
方案三:Python 脚本调用 TTS SDK 的可编程方案
如果你有 Python 开发经验且希望将 TTS 嵌入到自己的内容生产管线中,可以直接调用 TTS SDK 或云端服务的 REST API。
1. 适用场景
- 已有内容管理后台,需要定时批量合成;
- 需要将合成结果自动归类到指定目录结构;
- 需要与视频剪辑工具联动生成临时音频素材。
2. 伪代码思路
以 edge-tts 的异步 API 为例:
import asyncio
import edge_tts

TEXT = "这是一段用于测试的语音内容。"

async def generate_audio():
    tts = edge_tts.Communicate(TEXT, voice="zh-CN-YunxiNeural")
    await tts.save("output.mp3")

asyncio.run(generate_audio())
3. 限制与风险
- 需要额外编写异常处理模块,否则部分文本可能导致进程崩溃;
- 不同 TTS 服务商的 API 返回格式不统一,对接成本较高;
- 对于个人用户而言,学习和维护成本高于图形化工具。
方案总结与选型建议
方案
操作门槛
批量处理
网络依赖
适用人群
汇帮AI语音识别软件
低
支持多段文本
本地运行无网络依赖
非技术用户、自媒体运营者、教学人员
FFmpeg + edge-tts
中
可脚本化
需要网络
有命令行经验的开发者
Python SDK 编程
高
完全可编程
视所选服务而定
需要嵌入业务系统的开发团队
就本次测试体验而言,"汇帮AI语音转文字"在“复制文本-设置参数-导出音频”这条最短路径上表现稳定,适合高频次、低门槛的日常合成任务;命令行方案则更适合对自动化有要求的工程场景。
如果你也在做文字转语音,建议先明确自己是否接受命令行操作。接受,则优先评估接口稳定性;不接受,则直接选择图形化工具即可。
标签:文字转语音 TTS 汇帮AI语音识别 FFmpeg 音频合成
