
在日常开发与办公流程中,经常遇到需要将 MP3 录音内容整理为文字的场景。无论是会议纪要、采访稿整理,还是课程笔记沉淀,“mp3转文字如何实现”不是一个复杂的技术问题,但选错工具或方法,往往会浪费大量时间在校对和格式调整上。本文将抛开纯理论,直接分享两种经过验证的落地路径:一种是适合绝大多数办公用户的图形化工具,另一种是适合开发者进行批量处理的命令行方案。
方案一:使用汇帮AI语音转文字
汇帮AI语音转文字 提供了图形化的替代方案,具体配置流程如下:
1. 核心功能优势
该工具将复杂的 ASR 模型封装在本地或私有化环境中,减少了音频文件上传泄露的风险。从功能逻辑上看,它具备以下几个对办公场景友好的特性:
- 批量处理:支持同时导入多个 MP3 文件进行排队识别,无需逐个操作。
- 多格式输出:不仅支持导出为 Word,还支持 TXT、SRT(字幕)等格式,可直接对接后期剪辑或文档归档。
- 语种适配:内置了普通话、英语、粤语等常见语种的识别模型,可根据音频内容动态切换。
2. 详细操作流程
整个转换过程被简化为五个步骤,全程可视,无需记忆命令行参数。
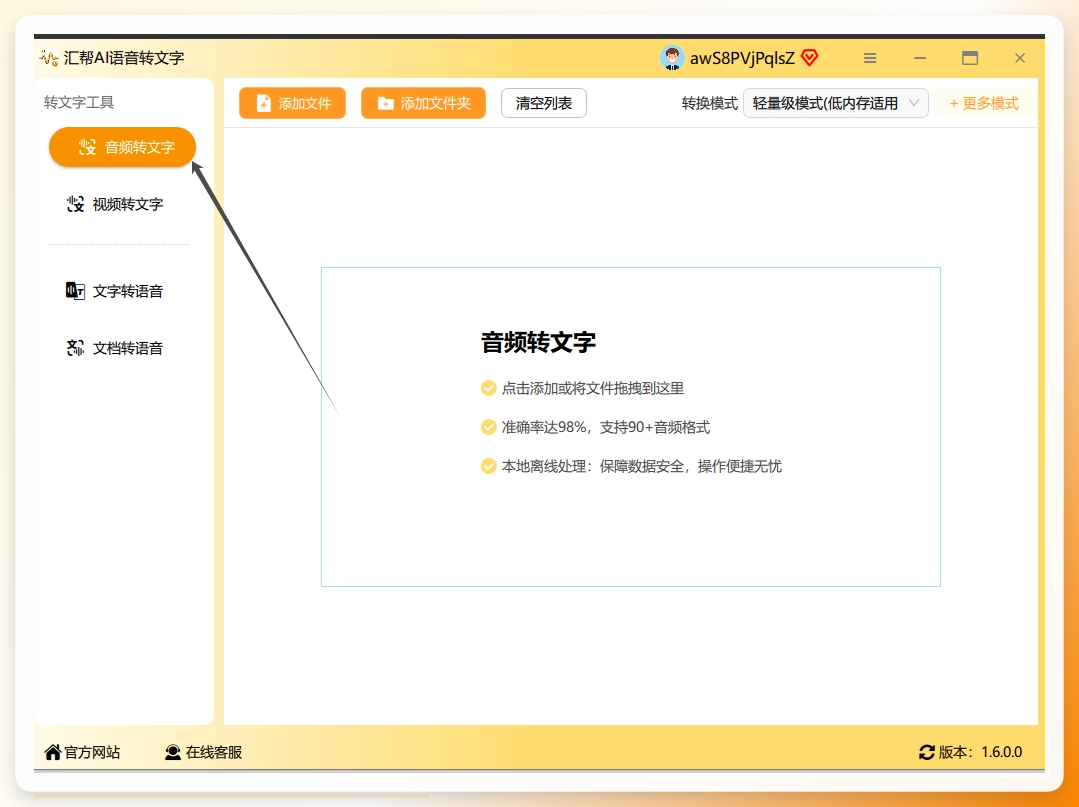
步骤1:启动软件并选择功能
双击打开电脑中的【汇帮AI语音转文字】软件。软件打开后,点击【音频转文字】功能。所有功能都集中在主界面上,一眼就能看明白,上手没什么难度。
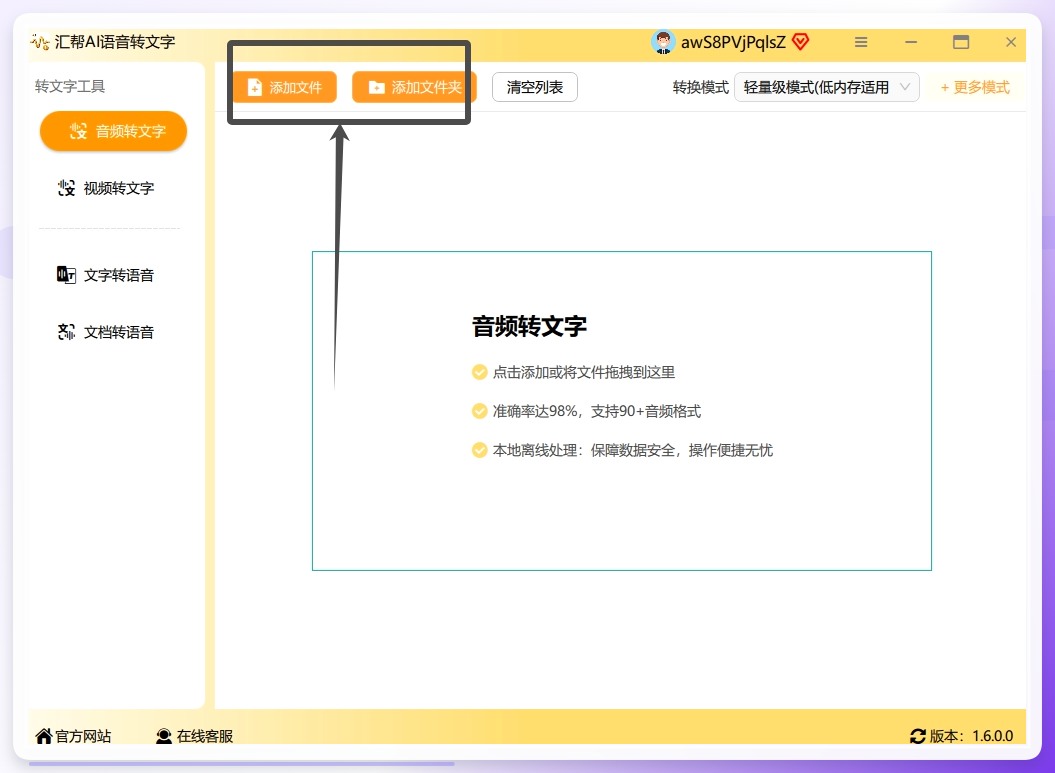
 ###### 步骤2:导入MP3文件
点击软件页面上的添加按钮,找到存放录音文件的文件夹,选中目标文件即可导入。
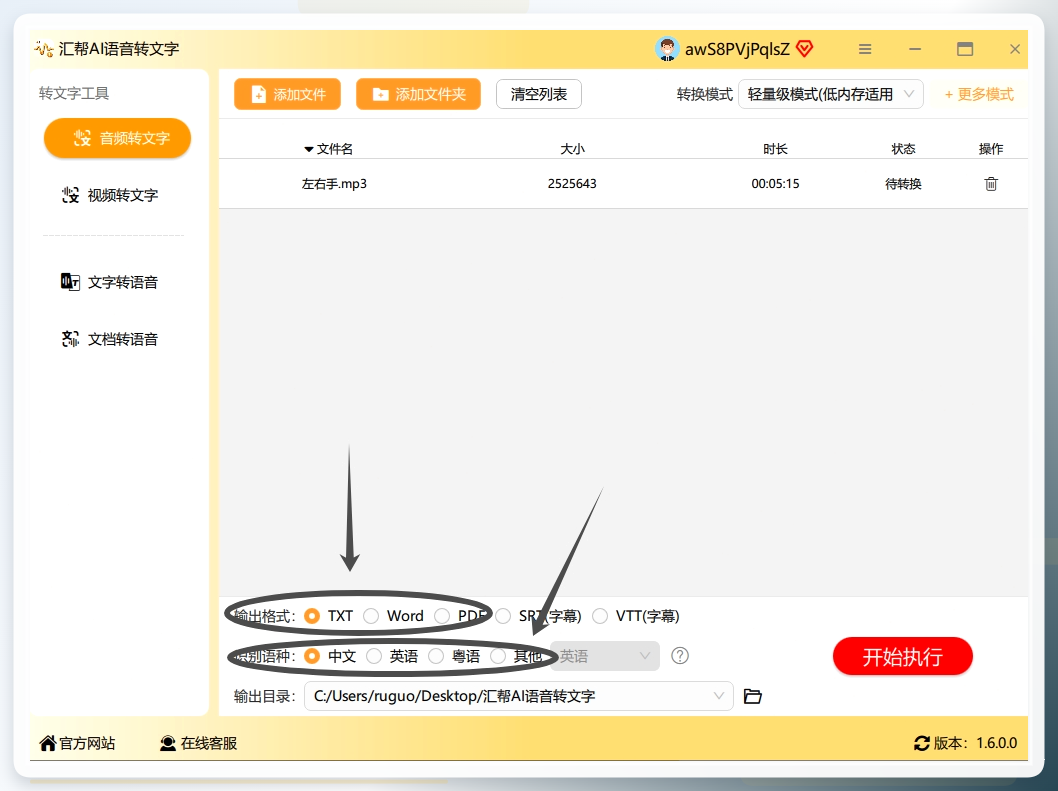
 ###### 步骤3:设置导出格式与识别语种
这一步需要留意一下:输出格式并不是只有 Word 一种选项,还支持多种文本格式,可以自由切换。如果你只是需要纯文本做关键词搜索,建议选择 TXT;如果需要提交正式的报告,则选择 Word。
 ###### 步骤4:执行转换
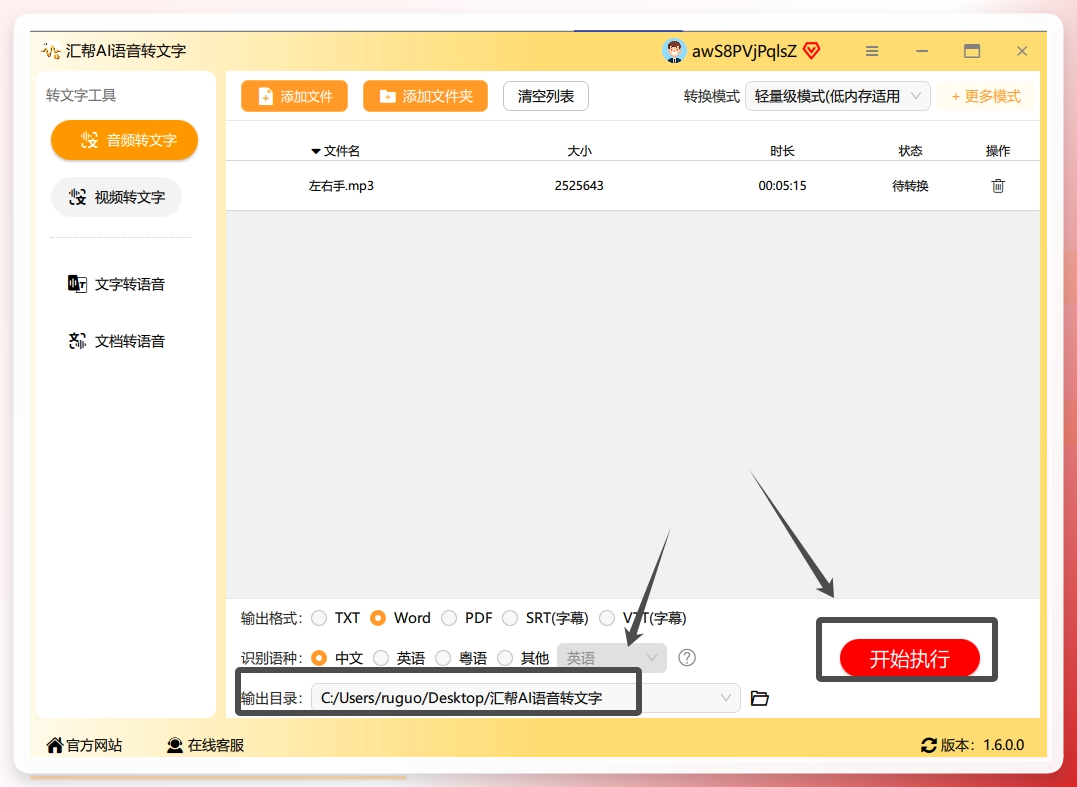
全部参数设置完毕后,点击页面下方的“开始转换”按钮等待处理。电脑会自动开始识别音频内容,如果文件比较大,多等一会儿就好。任务完成时,页面会提示转换成功。
 ###### 步骤5:检查导出结果
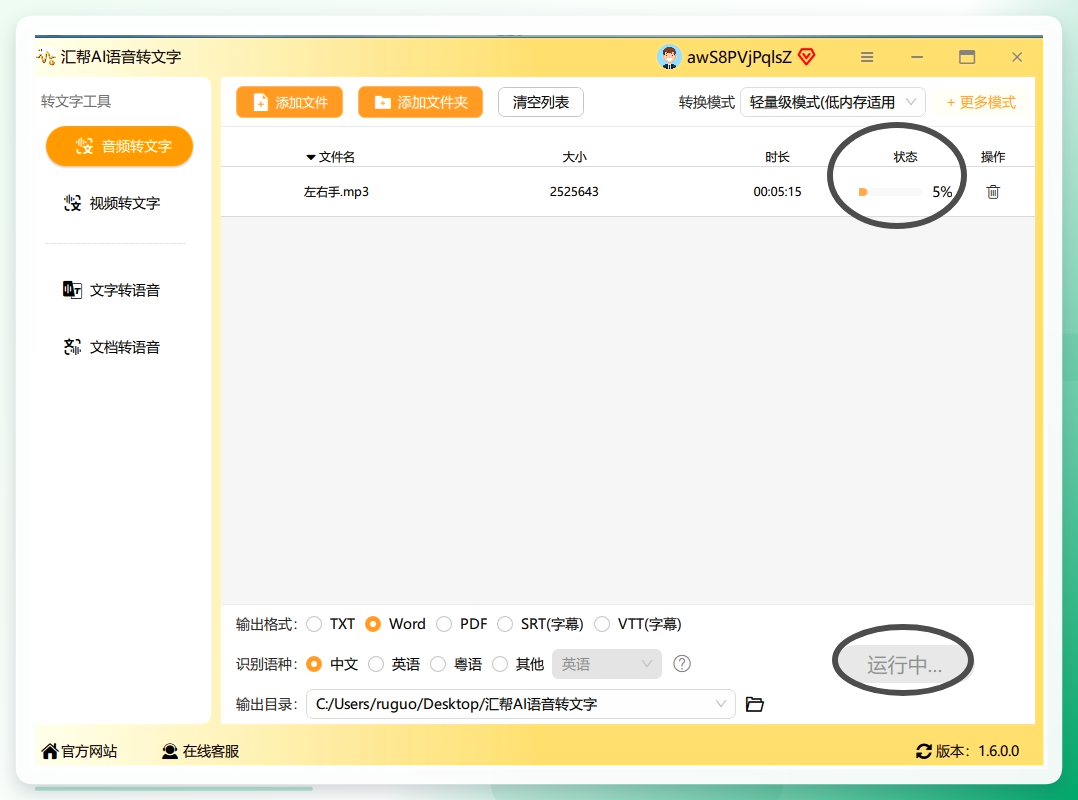
运行状态完成后,回到桌面上看看,你会发现转换好的 Word 文档已经自动生成好了。打开检查一下有没有明显错别字,就可以直接使用了。需要注意的是,对于带有浓重口音或专业术语较多的录音,建议在导出后使用文档编辑器的“查找替换”功能统一修正特定词汇。
方案二:FFmpeg + Whisper 命令行方案
对于开发者或需要构建自动化流水线的场景,使用 OpenAI 开源的 Whisper 模型结合 FFmpeg 进行音频解码,是一种高自由度且成本较低的方案。
1. 适用场景与前置条件
该方案要求使用者熟悉终端操作,且电脑需安装 Python 3.8+ 环境。其核心优势在于完全本地化运行,且模型参数可调,适合对隐私敏感或需要深度定制识别语言的用户。
2. 操作步骤
步骤1:安装FFmpeg
FFmpeg 是处理音频格式的核心工具。在 Windows 下,可通过 winget install ffmpeg 或下载预编译包并配置环境变量。在 macOS 下,执行 brew install ffmpeg。安装完成后,在终端输入 ffmpeg -version 验证是否成功。
步骤2:安装Whisper
使用 pip 包管理器进行安装。此处建议创建一个独立的虚拟环境,避免依赖冲突:
pip install openai-whisper
步骤3:执行转写
在终端中切换到音频文件所在目录,执行以下命令:
whisper meeting.mp3 --model medium --language Chinese --output_format docx
-
--model参数控制模型大小,tiny速度最快,large精度最高(但需要较大显存)。 -
--language指定识别语种为中文。 -
--output_format导出格式支持docx、txt、srt等。
3. 限制与风险
虽然 Whisper 免费且开源,但它对 CPU 性能要求极高。在无 NVIDIA GPU 加速的环境下,处理一段 1 小时的音频可能需要耗费数小时。此外,如果音频采样率低于 16kHz,识别率会显著下降,建议在运行前用 FFmpeg 对音频进行重采样:
ffmpeg -i input.mp3 -ar 16000 -ac 1 output_16k.wav
方案总结与选型建议
为了帮助读者快速决策,下表对两种方案的核心维度进行了对比:
对比维度
汇帮AI语音转文字
FFmpeg + Whisper
学习成本
低,图形化操作
高,需熟悉命令行
识别精度
针对办公场景优化,通用性强
依赖模型选择,large 模型精度更高
批处理能力
原生支持,可拖拽多个文件
需编写循环脚本,适合开发者
隐私安全性
本地处理,相对安全
完全离线,数据不外传
适用人群
职场白领、记者、行政人员
开发者、运维人员、极客
选型建议:如果你追求的是“当天拿到录音、当天出稿子”的效率,且不想参与任何环境配置,那么在方案一中选择 汇帮AI语音转文字 是体验最平滑的路径。如果你对技术有浓厚兴趣,且需要处理的数据量达到数百小时,建议投入时间学习 Whisper 方案,虽然前期配置繁琐,但在算力充足的情况下,长期边际成本更低。
本次关于 mp3 转文字的实操记录就到这里。你在转换过程中遇到过哪些奇怪的报错?欢迎在评论区留言,我们可以就具体的 ASR 调参问题进行探讨。
