
在日常开发与办公协作中,我们经常面临将会议录音、采访音频或课程讲义转为可编辑文本的需求。市面上的语音转文字软件虽然众多,但普遍存在三个痛点:识别准确率不稳定、导出格式单一以及上传云端带来的隐私泄露风险。
本文不讨论泛泛的“AI黑科技”,而是从工程化落地的角度,实测三条可行的技术路径。方案一将重点讲解如何利用汇帮AI语音识别软件在本地环境下完成高精度转写并直接导出为Word文档;方案二与方案三则提供针对不同技术背景读者的备选思路。所有操作均基于Windows 10/11 64位系统实测。
方案一:使用汇帮AI语音识别软件(本地化处理)
汇帮AI语音识别软件提供了一个无代码、低门槛的图形化解决方案。其核心价值在于本地化离线转写机制,音频文件无需上传至第三方服务器,从根源上规避了数据外泄的风险。
1. 核心功能优势
- 格式兼容性强:支持MP3、WAV、M4A、AMR、FLAC等主流及冷门音频格式,省去了转码的前置步骤。
- 多语言识别引擎:内置中文(普通话/粤语/方言)、英语、日语、韩语等多语种识别模型,适配国际化办公场景。
- 导出格式多样化:除本次演示的Word文档(.docx)外,还支持导出为TXT纯文本、SRT字幕文件,便于后续剪辑或归档。
- 批量任务处理:支持同时导入多个音频文件进行队列转写,有效提升处理效率。
2. 详细操作流程
步骤1:启动软件与功能选择
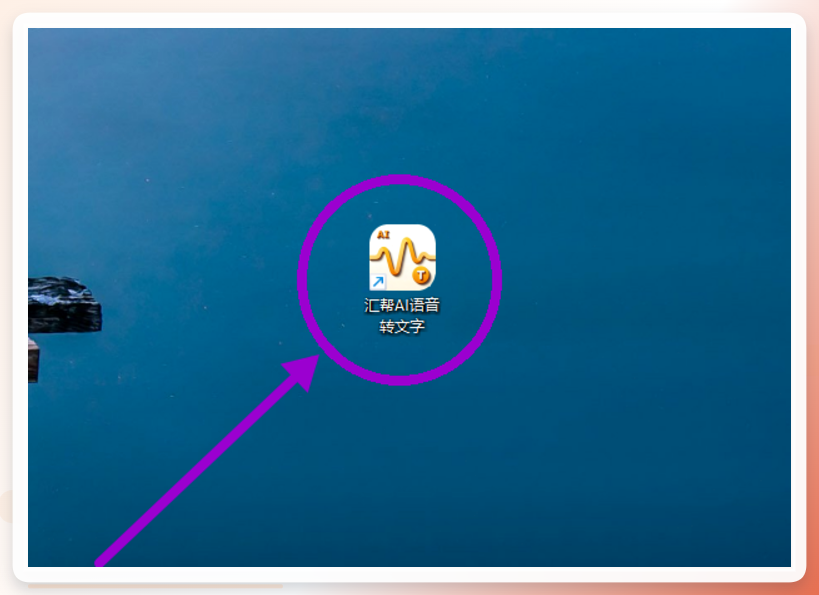
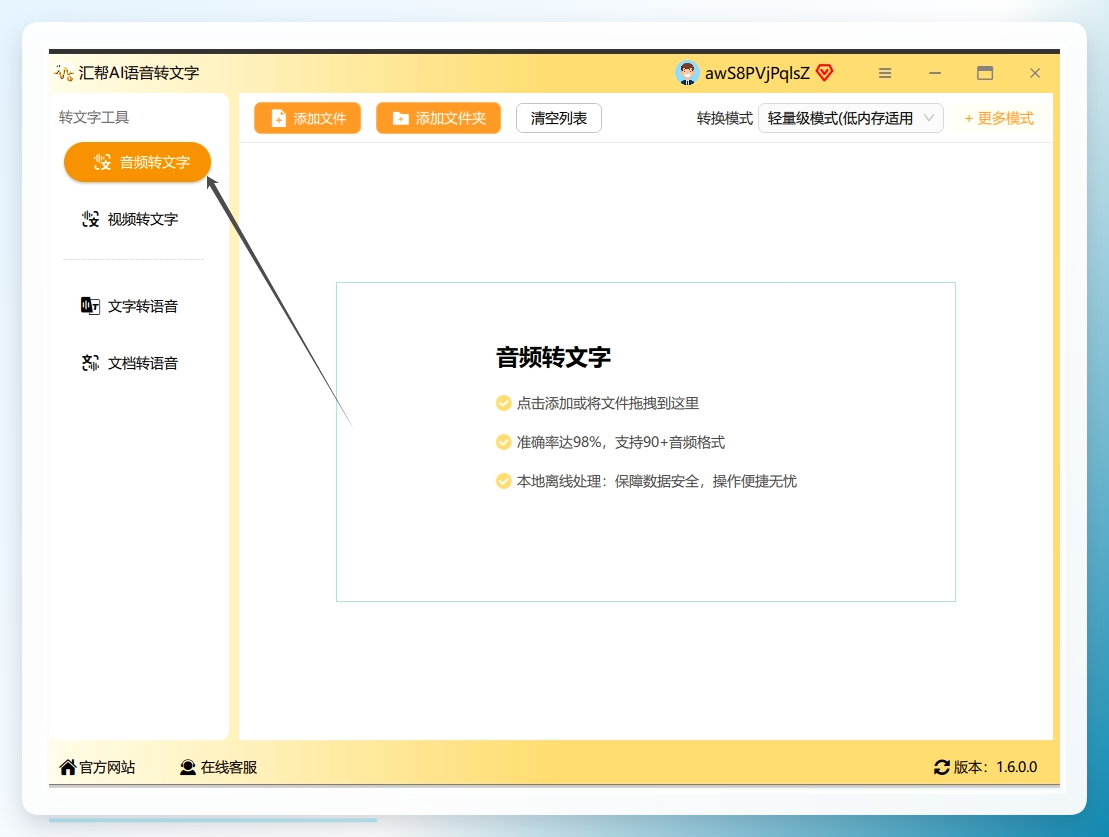
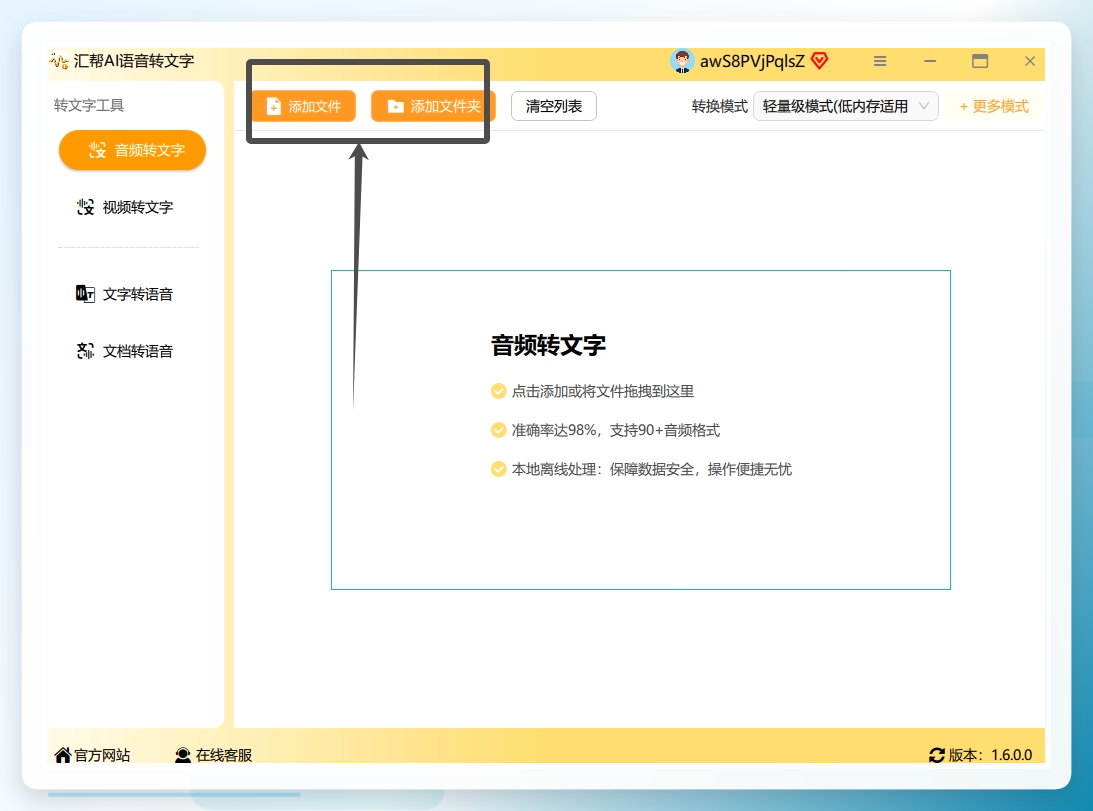
双击桌面上的“汇帮AI语音识别软件”快捷方式。进入主界面后,在左侧的功能导航栏中点击 【音频转文字】 模块。
步骤2:导入待转写的录音文件
在软件主操作区,点击 “添加文件” 按钮,在弹窗中选择需要转换的录音文件。此步骤支持多选,可一次性导入多个音频。
步骤3:配置输出格式与识别语种
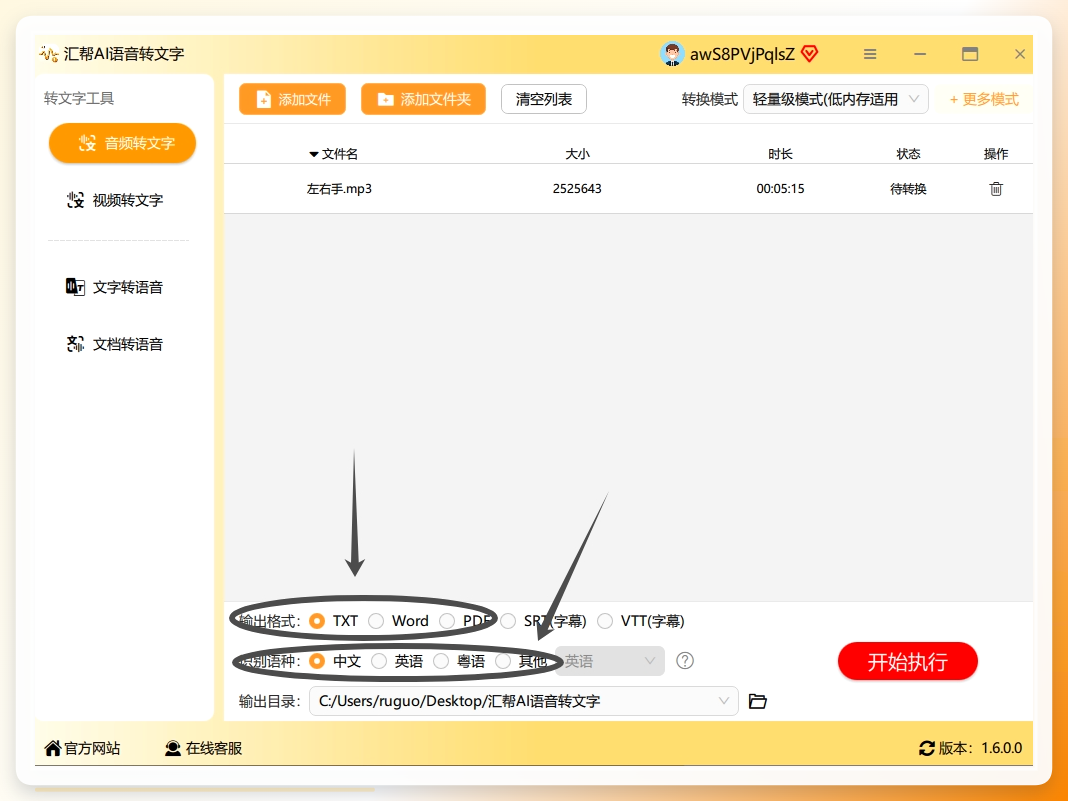
这是关键配置项。在输出格式下拉列表中,根据后续编辑需求选择 “Word文档” (.docx)。若需制作视频字幕,可选择“SRT字幕文件”。在语种识别区域,务必勾选与录音内容相匹配的语言,例如中文普通话或英语,以提升转写准确率。
步骤4:执行转换并检查产物
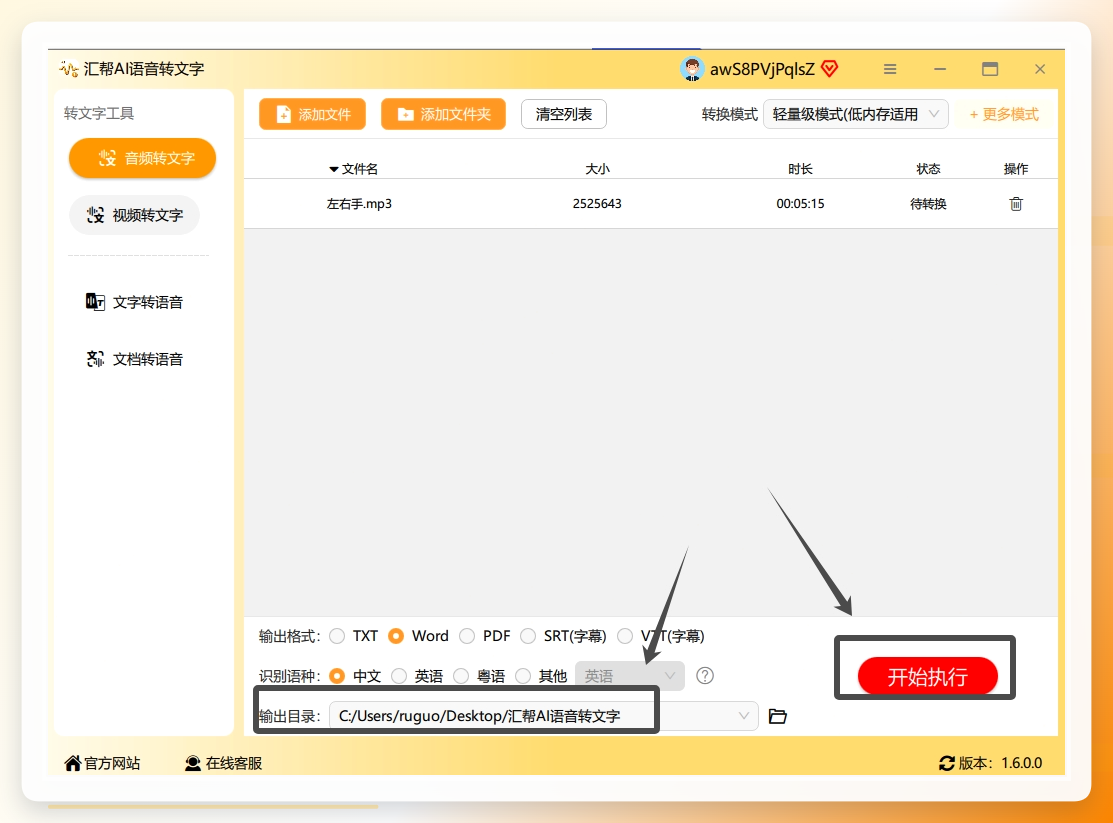
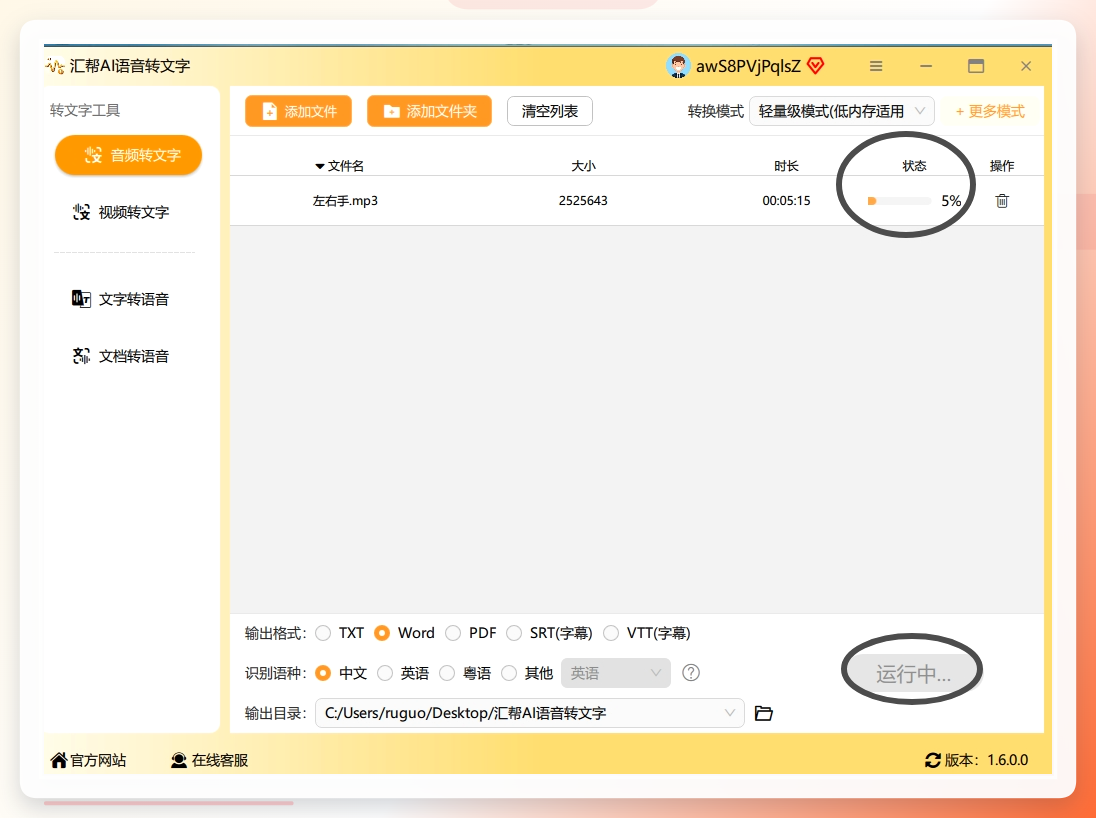
确认无误后,点击右下角的 “开始转换” 按钮。软件将进入自动处理阶段,处理时长取决于音频时长与硬件性能。转换结束后,点击弹出提示框中的“打开文件”或手动前往输出目录,即可查看生成的Word文档。
3. 结果验证与限制说明
经实测,在安静环境下录制的会议音频,该软件的中文转写准确率约为95%以上,且能够正确区分说话人分段(基于音频能量检测)。不足之外在于,当处理长达2小时以上的超长音频时,转写耗时约为音频时长的1/5左右,建议在午休或下班前提交任务。
方案二:使用剪映的“文稿”功能(免费轻量级)
若你并非频繁处理音频,只是偶尔需要将短视频中的语音转成文字,剪映专业版内置的智能字幕功能是一个零成本的替代方案。
适用场景:短视频字幕提取、轻量级采访粗转。 操作路径:
- 打开剪映,导入视频或音频文件。
- 将素材拖拽至时间轴,点击顶部菜单栏的 “文本” -> “智能字幕” -> “识别字幕”。
- 等待识别完成后,点击右上角 “导出”,在导出设置中勾选 “字幕导出”,可选择TXT或SRT格式。
限制与风险:该功能严重依赖网络,且导出TXT时不会附带时间码,仅适合快速获取纯文本内容。此外,剪映免费版导出的字幕文件在商业用途上存在授权风险。
方案三:基于 Faster-Whisper 的命令行流水线(技术进阶)
对于习惯使用命令行的开发者,Faster-Whisper 是一个基于CTranslate2重新实现的OpenAI Whisper模型,推理速度比原版快4倍,且显存占用更低。此方案适合需要私有化部署或进行批量脚本化处理的场景。
操作步骤:
-
环境准备:确保已安装Python 3.9+与FFmpeg。
pip install faster-whisper -
编写转换脚本:以下代码将自动识别当前目录下所有MP3文件并生成Word文档(通过txt文本封装)。
from faster_whisper import WhisperModel
import os, docx

model = WhisperModel("base", device="cpu", compute_type="int8")

for file in os.listdir("."):
    if file.endswith(".mp3"):
        segments, info = model.transcribe(file, language="zh")
        text = " ".join([seg.text.strip() for seg in segments])
写入Word
        doc = docx.Document()
        doc.add_paragraph(text)
        doc.save(file.replace(".mp3", ".docx"))
        print(f"已完成: {file}")
3. 执行操作:将脚本保存为 `transcribe.py`,在与音频文件相同的目录下运行 `python transcribe.py` 即可。

使用约束:`base` 模型在嘈杂环境下的准确率略低于汇帮的专用模型。若要求高精度,可更换 `large-v3` 模型,但推理时间会显著增加。

## 方案总结与选型建议

对比维度

方案一:汇帮AI语音识别

方案二:剪映智能字幕

方案三:Faster-Whisper

适用人群

办公文员、律师、记者

短视频创作者

开发者、科研人员

网络依赖

完全离线

强制联网

完全离线

输出格式

Word/TXT/SRT,直接可用

TXT/SRT

需自行编写脚本封装

学习成本

低(纯GUI操作)

低

高(需懂Python与CLI)

批量处理

支持

不支持

支持自定义脚本

隐私安全性

高(本地处理)

低(数据上云)

最高(完全本地)

综合建议:

- 如果你需要快速交付Word文稿且对数据安全有强制要求,建议直接选择方案一,它是目前平衡效率与安全性的最佳选择。
- 若仅为短视频配字幕,方案二的免费特性更具吸引力。
- 技术开发者若追求极致的定制化与自动化流水线,可以深入研究方案三。

你在使用`语音转文字软件`时还遇到过哪些问题?欢迎在评论区交流你的踩坑经历。
